AI-HATS: Агентная разработка done right
Большие языковые модели уже достаточно неплохо решают отдельные задачки. Хорошо решают олимпиадные задачи, пишут базовые сервисы — на SWE-bench Verified лидеры уже в высоких 80%, — позволяют вайб-кодить всем, без знаний программирования.
Проблемы
Общий заход
Однако, когда начинаешь применять их к себе, сталкиваешься с ограничениями, присущими всем моделям.
Нечёткие требования ведут к решению не той задачи.
Человек в разговоре достраивает недосказанное — модель достраивает тоже, только по-своему. Она не переспрашивает, а выбирает наиболее вероятное продолжение. На выходе аккуратно написанный код, который решает другую задачу. И понимаешь это не когда правил формулировку, а через полчаса, когда смотришь на готовый дифф.
У моделей нет контекста, как в конкретном проекте делаются изменения.
В любом живом репозитории есть правила: куда класть новый модуль, чем его тестируют, что здесь считается допустимым хаком, а что нет. Модель этого не знает и подставляет усреднённое по интернету — усредненный стиль, усредненную структуру, усредненную библиотеку вместо той, что уже стоит в проекте.
Из ложных предпосылок не вывести правильное следствие.
Два предыдущих пункта складываются в фундаментальную проблему: агент пишет код, который ломает текущий репозиторий. Дальше на этот код опирается следующий агент — и строит уже на фикции. Чем длиннее цепочка, тем дороже разбор. Складываются и мультиплицируются все проблемы: от пропущенных требований до невалидных тестов. И чем дольше живёшь в таком бардаке, тем сложнее процесс достижения целей.
Несколько харнессов
Несколько харнессов в одном проекте — это дрейф правил и ещё больше слопа.
Ещё хуже дела начинают обстоять, когда хочется в проекте несколько разных подходов — например, Claude и Gemini.
Начинаются расхождения: забыл перенести знания из claude.md в gemini.md.
Форматы разрешений (permissions) несовместимы — allow/ask/deny в settings.json у Claude Code против своей схемы настроек у Gemini CLI — и приходится либо сидеть и жать «да, да», либо давать yolo-mode: --dangerously-skip-permissions.
Каждый харнесс тянет свою интерпретацию правил, и они обязательно будут расходиться. Через месяц это два набора инструкций, описывающих два разных проекта, и какой из них сейчас правдивый — не знает никто. Дрейф не остаётся в конфигах: агенты работают по разошедшимся инструкциям, так что слоп прирастает с обеих сторон сразу.
Отсутствие обратной связи
Агентам нужна петля обратной связи между сессиями.
Модели это stateless-функции: каждый запрос несёт всю историю разговора целиком, своей памяти между вызовами у них нет. Они не знают, что делала предыдущая модель, и не понимают, с какими проблемами она столкнулась, на какие требования опиралась, на какие инварианты надеялась. Это значит, что новая сессия столкнётся с теми же самыми проблемами снова и снова — «безумие — делать одно и то же и ждать другого результата». Пользователю остаются два пути - каждый раз объяснять или скатываться в нейрослоп, с умножением проблем.
Всё, что прошлая сессия выяснила дорогой ценой — что тест падает из-за таймзоны, что в этом модуле нельзя трогать порядок инициализации - умирает вместе с её контекстом. Между сессиями нужна петля обратной связи: место, куда агент кладёт выводы, и правило, по которому следующий агент обязан следовать. Сама собой такая петля не возникает.
Решение
Мне потребовалось некоторое время, чтобы осознать: проблема агентной разработки не в самих агентах, а в инфраструктуре и управлении ими для достижения нужного результата.
AI-HATS — это фреймворк для работы с агентами, где человек это ключевое управляющее воздействие.
Ближайшая аналогия — усилитель. Модель — источник мощности: сырой и безадресный. Человек — управляющий сигнал: слабый по энергии, но именно он задаёт форму. Ai-hats — рабочая точка, в которой намерение усиливается, а не превращается в шум. Без неё мощность есть, а результата нет.
Каждую проблему ai-hats закрывает своим уровнем:
Backlog layer + перекрёстные ссылки. У агентов есть общий бэклог: карточки задач, состояния, связи между ними. Агент не просто делает работу — он пишет в карточку, что выяснил, на что напоролся и куда смотреть следующему. Это и есть та самая петля обратной связи: новая сессия стартует не с чистого листа, а с выводов предыдущей.
Но память — это только половина петли. Вторая половина в том, что на контексте прошлых сессий можно менять поведение агентов: ставить эксперименты, выдвигать гипотезы и предлагать улучшения. Работает это потому, что сессию видно со стороны: она пишет собственный аудит, и его можно оценить автоматически, а не на глаз.
Как работает петля обратной связи
После сессии запускается ретро - специальный no-hitl шаг пайплайна ai-hats. Агент смотрит на прогон сессии с человеком и оформляет находки в две сущности: гипотезу — «кажется, вот здесь поведение сбоит» — и предложение — «вот так это чинится».
Дальше они не тонут в чате, а живут в том же бэклоге рядом с задачами, и их можно проверять экспериментом: сформулировать вопрос об одном сценарии, прогнать варианты и сравнить. Получается контур: сессия оставляет след, след превращается в гипотезу, гипотеза — в правку поведения или кода. Следующая сессия работает уже по исправленным рельсам.
WT layer + quality gate на рёбрах. Каждая задача едет в своём work tree — агенты работают параллельно и не наступают друг другу на пятки. Влиться в основную ветку изменения могут только через quality gate проекта. Ломающий код не попадает в базу, на которой строят остальные, и предпосылки у них остаются честными.
Role layer + знания о харнессах. У агента ровно та роль, модель и харнесс, которые нужны этой задаче. Роль собирается из трейтов, правил и скиллов — в контекст не приезжает то, что задаче не пригодится. А знание о харнессах лежит в одном месте и раскладывается по контексту самостоятельно, поэтому копиям правил больше некуда расходиться.
Что это меняет для человека
Слои — это внутреннее устройство. Снаружи важнее другое: кто именно держит всё это в порядке.
Фреймворк работает за тебя, а не ты за фреймворк.
Не надо помнить, какой скилл сейчас подключить, как разбить работу на задачи и в каком порядке их делать. Это работа агента: он сам достаёт нужный скилл, сам декомпозирует, сам заводит карточки и связывает их между собой. Человек не обслуживает фреймворк — фреймворк вытягивает нужное поведение из агента.
Агент не угадывает — он спрашивает.
Разницу делает фаза планирования. Агент сперва разбирается в коде, потом выкладывает план, а там, где развилка принципиальна, останавливается и задаёт вопрос: вот варианты, вот моя рекомендация, решай. Развилки закрывает человек, реализацию делает агент — и она выходит той, которую автор имел в виду, а не наиболее вероятной. Сильная фаза планирования переходит в правильную реализацию; слабая — в аккуратно оформленное «хуйня, переделывай».
Поэтому на входе достаточно наброска. Вернёмся к первой проблеме: нечёткие требования ведут к решению не той задачи. С фреймворком это поведение меняется. Агент снимает нечёткость до работы и написания кода - вопросами и уточнениями. Задача может прийти в виде «у меня болит вот это», без требований, критериев приёмки и списка файлов. Требования из неё выведут агент и фреймворк, а покажут их тебе на подтверждение.
Из наброска в требования: как это выглядит на самом деле
Вот что я написал агенту в сессии, с которой начинается вторая половина статьи — ни одного требования, только боль и желаемый флоу:
у меня есть проблема:
я хочу ревьюить код агентов через hunk(этот репозиторий), но в нем нет способа реализовать следующий флоу:

-> агент сделал задачку
-> агент говорит мне в какой ветке
-> я запускаю hunk на этой ветке
-> пишу комментарии и закрываю hunk
-> говорю агенту, что ревью сделано, агент сам читает комментарии и делает исправления
-> после: повторное ревью задачки

Подумай как сделать такой флоу и какие шаги нужны. Обсудим план
А вот что из этого выросло в plan.md, который агент написал сам — с разделами,
разбором альтернатив и явно отклонёнными вариантами:
## Requirements

Today `userNotesByFileId` (`useReviewController.ts:221`) is React state only and
dies with the process. Nothing in `src/` persists review state — the only
TUI-to-disk writer is `writeConfigSource` (`config.ts:428`), for view prefs.

Functional requirements:

1. A user note survives Hunk exiting, including `SIGINT`.
2. An agent can read notes with no live TUI and no daemon.
3. A second review pass with zero findings must NOT replay the previous round's
   comments.
4. No silent destruction of comments the agent never read.

## Approach & counter

Frame the file as a **mailbox**, not a store.

Counter-options considered and rejected:

- *Truncate on session open* — "opened Hunk just to look" destroys yesterday's review.
- *Staleness detection via HEAD sha / patch hash* — needs the headless command to
  re-run the diff, and a sha-based signal misses uncommitted fixes.
Обрати внимание на третий пункт требований и на список отклонённого. Я про это не говорил ни слова — агент сам нашёл случай «второй проход без замечаний» и сам объяснил, почему две очевидные альтернативы не годятся.
Между этими двумя текстами стоит plan-gate — обязательный этап перед реализацией.
Задача не переходит в работу, пока в плане не заполнены требования, разбор альтернатив,
границы скоупа и способ проверки.
И это не уговор с агентом, а поведение харнесса: карточка живёт в состояниях
brainstorm → plan → execute, и переход в execute отклоняется, если разделы плана пустые.
Обойти этап, начав сразу писать код, не получается — двигать задачку по неправильному флоу
просто не даёт трекер.
Дальше — как это выглядит вживую.
Как пользоваться
На ваших глазах решу задачку, с которой сам столкнулся в разработке
В своём флоу для ревью агентского кода в work tree я хочу использовать утилиту hunk. Она позволяет ревьюить агентский код выделенный в отдельные ветки и diff’ы. К каждой строчке можно прикрепить комментарий и следить за новыми комментариями в real-time режиме.
Мне очень нравится такое ревью: как локальный Github. Агент сделал изменения, я посмотрел и написал комментарии.
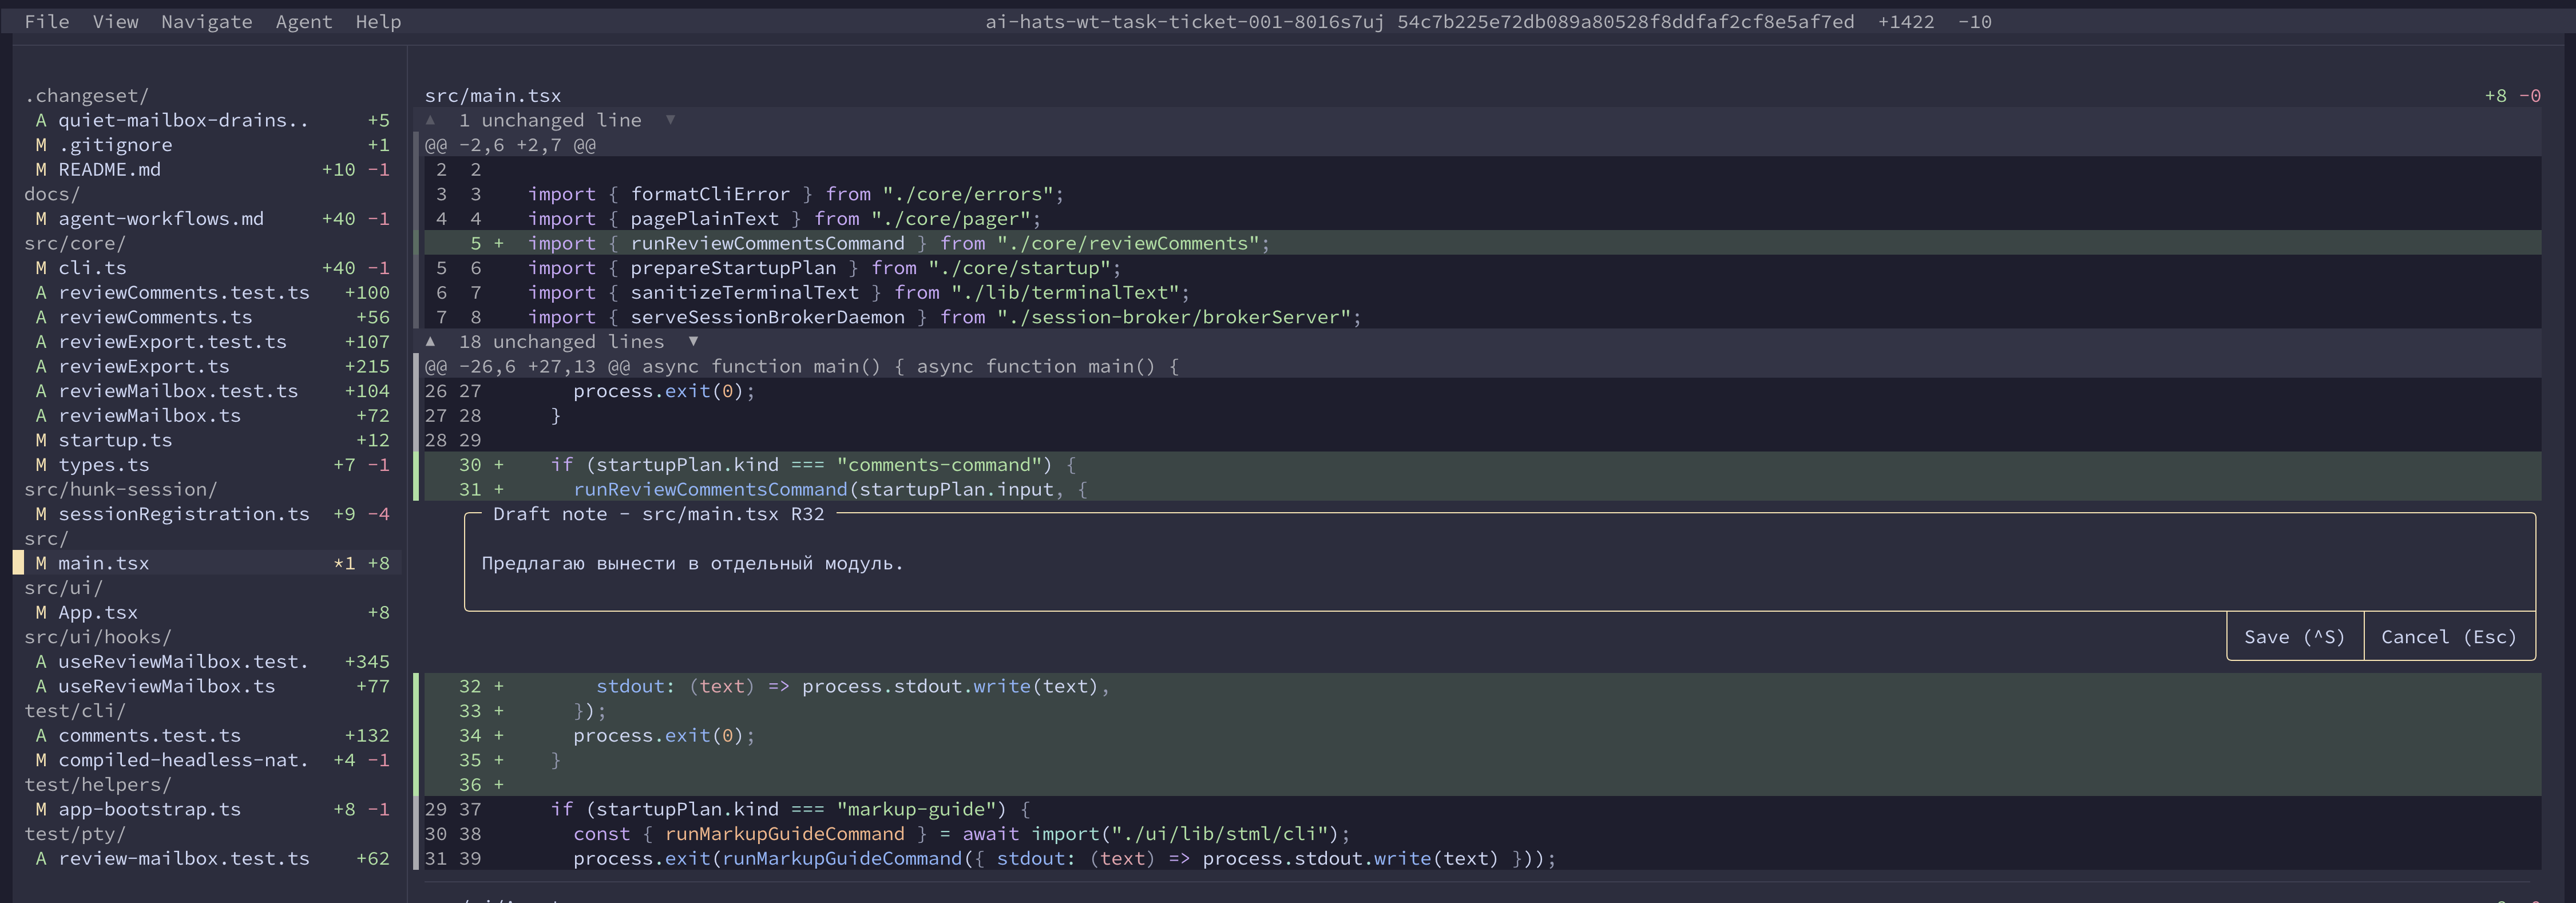
Однако, в hunk есть недостаток - ревью живет только пока активен сам hunk. Hunk - закрывается, все комментарии пропадают. Для меня это не очень удобно: я привык к ревью на GitHub / GitLab, когда можно написать все комментарии, просмотреть их и только потом вылить их одним изменением. Из коробки hunk это не поддерживает, но давайте я покажу, как сделать это в рамках агентной разработки с ai-hats.
Устанавливаем ai-hats и hunk
curl -sSL https://github.com/muratovv/ai-hats/raw/master/scripts/install-launcher.sh | bashЧто делает эта команда
Кладёт в ~/.local/bin/ai-hats небольшой bash-лаунчер — это и есть точка входа.
Сам фреймворк в проект ставится отдельно: лаунчер поднимает для него изолированный
venv через uv внутри .agent/ai-hats/ и запускается уже оттуда. Поэтому обновление
фреймворка в одном проекте не задевает остальные.
Клонируем Hunk и инициализируем ai-hats
git clone https://github.com/modem-dev/hunk
cd hunk
ai-hats self init # запускаем инициализацию ai-hats в проекте
Инициализацию сделаем через туториал (wizard).
В рамках статьи я пропущу, что происходит в wizard, но скажу, что wizard написан на тех же примитивах, что и весь ai-hats - своя роль, понимание фреймворка и отдельный pipeline исполнения.
Подробнее: роль initial-wizard и разбор всех шагов настройки.
Первая рабочая сессия
Тут мы начинаем реальную работу
ai-hatsЗапускаем ai-hats — сессия стартует с настройками проекта: провайдер claude и роль assistant, которую предложил init wizard.
Остальные команды запуска — в документации, полный справочник по CLI выдаёт ai-hats --tree.
Какие ещё бывают роли
Полный список выдаёт ai-hats list roles — там базовый assistant, dev-python,
dev-web, go-dev, architect, maintainer, role-curator и другие; рядом видно,
из скольких трейтов, правил и скиллов собрана каждая
(исходники ролей).
Как собрать собственную роль — how-to-extend.md.
Описываем задачку:
Харнес открылся, описываем задачку.
у меня есть проблема:
я хочу ревьюить код агентов через hunk(этот репозиторий), но в нем нет способа реализовать следующий флоу:

-> агент сделал задачку
-> агент говорит мне в какой ветке
-> я запускаю hunk на этой ветке
-> пишу комментарии и закрываю hunk
-> говорю агенту, что ревью сделано, агент сам читает комментарии и делает исправления
-> после: повторное ревью задачки

Подумай как сделать такой флоу и какие шаги нужны. Обсудим план
Агент уточняет по пути как и что работает. Предлагает план и говорит как лучше сделать с его точки зрения.
Где-то соглашаемся, где-то спорим.
Важно то, что агент теперь управляет состоянием: он не бросается решить все сразу. Он разделил задачку на независимые кусочки флоу - добавление фичи сохранения состояния ревью в hunk и создание агентского flow на основе hunk.
В бэклоге агента теперь есть задачки: TICKET-1, которую агент довёл сам в рамках сессии, и TICKET-3 — организация навыка на основе hunk.
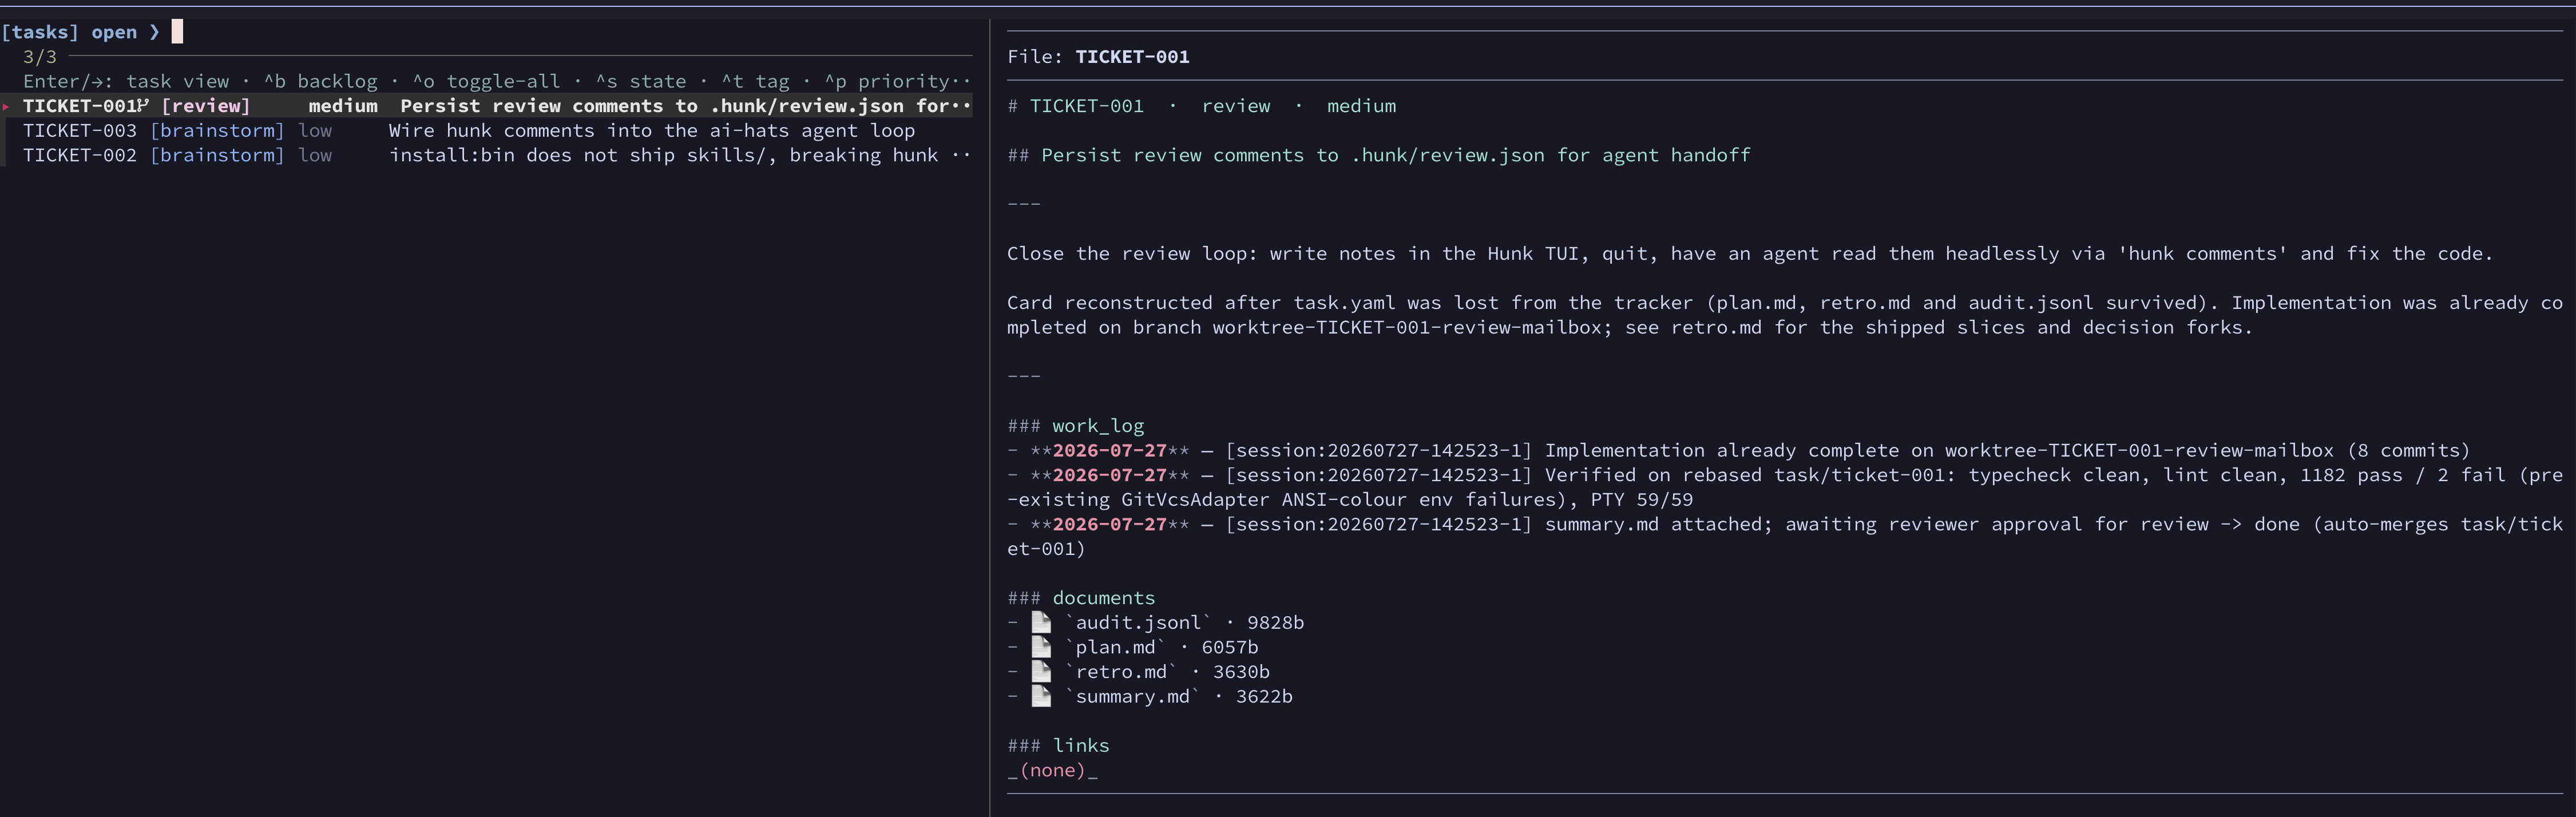
А откуда взялся TICKET-2
Пока агент разбирался в устройстве hunk, он наткнулся на посторонний баг: install:bin
не кладёт в сборку каталог skills/, из-за чего у локально собранного бинаря ломается
путь к скиллу. Агент не стал чинить его по дороге и не забыл про него — завёл отдельную
карточку TICKET-2 и вернулся к своей задаче. Это и есть управление состоянием: находка
не теряется и не превращается в самоволку посреди чужой работы.
Как устроен бэклог в ai-hats
Система бэклога — отдельный модуль, дающий агентам долгосрочную память по работам в проекте. Задачки в бэклоге ведутся агентами и для агентов. Я считаю, что переписывать руками требования в карточках — достаточно бесполезная работа: современные модели справляются с генерацией текста сильно быстрее людей.
Для этого у агента есть инструмент rack — через него он пишет задачки, связывает их
между собой и полноценно управляет бэклогом проекта. Если хочется выжать из бэклога
максимум, вот подробная документация.
В бэклоге живут три типа карточек: задачи, гипотезы и предложения — у каждого свой
жизненный цикл. А сами бэклоги настраиваются под себя: меняется и содержимое карточек,
и то, что происходит на переходах между состояниями.
TICKET-3 — более тонкая задачка: она связывает наш проект и наш харнесс - мы хотим чтобы в ai-hats теперь был флоу ревью. Чтобы это сделать - нужна роль, которая знает про ai-hats и тонко умеет настраивать поведение агентов. Это role-curator.
Вызываем:
ai-hats -r role-curatorПочему для этого нужна отдельная роль
role-curator — роль, которая курирует саму библиотеку поведения: роли, трейты, скиллы,
правила. У неё для этого специальная начинка — трейт skill-engineer (как устроен скилл
и какой у него чеклист приёмки), трейт library-curator (как разложена библиотека и куда
что класть) и скилл review-role для приёмки результата. Приоритеты у роли тоже свои:
когерентность композиции, минимализм без спекулятивных примитивов, следование конвенциям.
Отдельная роль нужна ровно потому, что менять поведение агентов — это другая работа, а не продолжение текущей. Роль, которая пишет фичу, оптимизирована под фичу: у неё в контексте код проекта и его правила. Попроси её заодно подкрутить свои же инструкции — и получишь скилл, написанный под один частный случай, из головы, без чеклиста. Здесь же всё наоборот: в контексте — устройство библиотеки, а задачи проекта - полигон для экспериментов над поведением.
Закрываем первую задачу
Пока я занимался ролью, первая задача дошла до состояния review.
Это и есть точка, где решаю я: посмотреть изменения и либо принять, либо вернуть.
Ревьюю я их в hunk — той самой утилите, для которой всё и затевалось. Забавно выходит: смотрю фичу, которая учит hunk сохранять ревью, а комментарии на этом проходе ещё пропадают при закрытии. Последний раз.
Приёмка — это перевод карточки из review в done.
Не формальность: на этом переходе ветка задачи вливается в основную.
Изменения попадают в main не тогда, когда агент сказал «готово», а когда прошли gate.
И здесь случилось ровно то, ради чего гейт нужен.
Пока агент делал задачу, основная ветка уехала вперёд на 15 коммитов — там приехала новая система расширений, переписавшая тот же App.tsx на +265/−67 строк.
Влить «как есть» было уже нельзя.
Агент перебазировал ветку, разрешил конфликт импортов и прогнал проверки заново — и только после этого задача уехала в done.
Что показывает гейт
Прогон на перебазированной ветке: typecheck чисто, lint чисто, юнит-тесты
1182 прошли и 2 упали, PTY-тесты 59 из 59.
Два падения — не регрессия: это тесты GitVcsAdapter, которые ловят цвет в выводе
git и падают на моей машине из-за глобального git-конфига. С изолированным
конфигом файл проходит целиком. Такие вещи важно уметь отличать: гейт показывает
красное, но красное бывает чужое, и роль объясняет, чьё именно.
Кроме кода агент оставил в карточке summary.md: что поехало, какими срезами, какие
решения приняты и почему. Это не отчёт для меня — это контекст для следующего агента.
Вторая сессия: роль под задачу
Теперь вторая задача — научить агента пользоваться тем, что мы сделали. Для неё нужна другая роль, и сессию я начинаю с одной строки:
давай возьмем задачку 003Ни слова о том, что это за задача.
Правильная роль — это правильный контекст. Агент уже знает бэклог.
Агент сам достал карточку, прочитал соседнюю закрытую задачу, её план и ретро, разобрался в устройстве репозитория — и вернулся с планом.
План, впрочем, был не тот. Агент нашёл у меня на машине старый скилл под предыдущую реализацию и предложил его мигрировать. Я ответил одной строкой:
погоди, мигрировать ничего не нужно. Мы делаем новый скилл с новой имплементацией hunkДальше он не бросился переписывать, а сначала спросил, где новому скиллу жить, и только потом переписал план целиком. Решение получилось лучше моего изначального: скилл лёг рядом с уже существующим в самом hunk и поедет вместе с пакетом — то есть достанется всем, кто поставит утилиту, а не только мне.
Скилл выходит минимальным, покрывающим и с гарантиями — сразу, а не после трёх итераций.
Вот ключевой кусок — по сути весь флоу:
### 1. Read the mailbox once

hunk comments --json

### 2. Keep the payload

Reading **drains**: the comments move to `.hunk/review.done.json` and the
command returns an empty review from then on.

### 3. Fix every comment

Each entry is a required fix, not a suggestion.
А вот то, чего я не просил и что отличает скилл от пересказа документации:
- **Calling `hunk comments` before you are ready to act on the result.** It is
  the drain, not a peek: whatever it prints has already left the mailbox.
- **Re-running the command to recover a list you lost.** The second call returns
  an empty review by design. Read `.hunk/review.done.json` directly instead.
Что здесь считается гарантией
В скилле есть раздел с валидационным сценарием — красное и зелёное поведение:
RED: told "the review is done" in a checkout with a full `.hunk/review.json`
and no live session, an agent runs `hunk session list`, finds nothing, and
reports that there is no review to read — the comments are never seen.
GREEN: with this skill it runs `hunk comments --json` in the checkout and turns
each returned entry into a fix.
То есть скилл описывает не только «как надо», но и конкретный способ провалиться,
который он предотвращает. Это требование роли role-curator, а не моя просьба:
у неё в приоритетах «минимализм без спекулятивных примитивов», а в композиции —
чеклист приёмки скиллов.
Заодно агент отделил новый скилл от соседнего, который управляет живой сессией hunk: у них разные триггеры и разные инструменты, и перепутать их — верный способ заставить агента искать сессию, которой нет.
Побочный продукт сессии — ещё две карточки: подключить скилл в композицию ролей и починить обнаружение соседних скиллов в собранном бинаре. Ни то, ни другое агент не стал делать по дороге.
Как это выглядит, когда цикл замкнут
Отгруженный скилл — это ещё не работающая петля: файл лежит в репозитории, но ни к одной роли не подключён. Подключение агент вынес отдельной карточкой и делать по дороге не стал.
Зато у меня такая петля уже крутится каждый день — на предыдущей реализации, которая писала заметки в .hunk/notes.json.
Устроена она из трёх частей, и это ровно то, во что превратится новый скилл, когда его подключат.
Первая часть — сам скилл: он срабатывает на фразу «поревьюил», забирает заметки, чинит код и пишет отчёт в карточку.
Вторая — скрипт, у которого чтение и есть очистка: он печатает заметки, кладёт бэкап в /tmp/review/ и опустошает sidecar одним шагом.
Отдельного «не забудь очистить» не существует, потому что забыть нечего.
Третья часть — самая интересная.
Заметки лежат внутри worktree и не попадают в git, а значит wt merge унесёт их вместе с деревом.
Поэтому скилл объявляет в своём же фронтматтере хук:
ai_hats:
  worktree:
    wt_out:
      - script: hooks/drain-review.sh
        on: [merge, discard, cleanup]
ai-hats материализует этот скрипт и запускает перед каждым сносом worktree. Хук fail-closed: не смог слить заметки — снос отменяется, дерево остаётся.
Дисциплина, которую нельзя забыть, — это не памятка, а хук в жизненном цикле.
Работает это не в теории.
Вот хвост журнала дренажа с моей машины: 478 записей, срабатывание на каждом merge и discard.
2026-07-25T09:58:09Z  OK event=merge branch=task/hats-1204 drained=1 backup=/tmp/review
2026-07-27T20:03:33Z  NOOP event=merge branch=task/hats-1248 (no sidecar)
2026-07-27T21:52:01Z  NOOP event=merge branch=task/hats-1253 (no sidecar)
NOOP — ревью не было, сносить нечего.
drained=1 — заметка нашлась и уехала в бэклог задачи, а не в мусор вместе с worktree.
Все три части выложены целиком: скилл, скрипт и хук в одном гисте.
Забирайте, кладите в ~/.ai-hats/skills/, подключайте к своей роли — там же в README установка и оговорка, какой из двух вариантов брать под вашу версию hunk.
Вместо заключения
Агентская разработка становится новой реальностью: компьютеры генерируют тексты намного быстрее людей. Нам остается только ревьюить и направлять поток в нужную сторону.
Я знаю много талантливых ребят, которые еще не очень активно пользуются подобными подходами. Очень надеюсь, что эта статья станет стартом к новому подходу в вашей созидательной работе.
Всех обнял, muratovv